
BV-SALA Savings Layer: Verifiable Measurement of Cost Savings in Large Language Model Applications
Cómo medir el ahorro de coste de una capa sobre un LLM sin inflarlo: solo cuenta como ahorro lo que confirma el contador de facturación del propio proveedor, cada escenario se mide dos veces (con la capa y sin ella), el ahorro se reparte en cuatro ledgers que nunca se suman y cada cifra se publica con su intervalo de confianza del 95 %. Paper en inglés, con un resumen de conclusiones en español.
Resumen
El resumen de conclusiones en español que cierra el propio paper:
Este trabajo ha formalizado la metodología de medición de BV-SALA Savings Layer, una capa de optimización de costes para aplicaciones basadas en LLM cuyo principio rector es contable antes que algorítmico: solo cuenta como ahorro lo que el contador de facturación del proveedor confirma. La arquitectura —SDK en proceso con cero dependencias en ejecución para Node.js y gateway local para agentes de código— mantiene el tráfico directo entre aplicación y proveedor y limita la exfiltración a recuentos e importes. La contabilidad en cuatro ledgers separados impide inflar el ahorro por doble cómputo, y el protocolo de doble ejecución con intervalos de confianza al 95% (31,5% en
gpt-4o-miniy 75,1% enclaude-sonnet-5sobre un flujo con un 30% de repeticiones exactas, y 2,5% neto con la palanca PRO del gateway) convierte el ahorro en una magnitud medible, auditable y comparable. El trabajo futuro amplía la base empírica a más proveedores y tráfico de terceros, completa la medición A/B de la skill de suscripción y caracteriza la interacción entre ledgers cuando varias palancas se activan a la vez.
Los intervalos y el desglose de esas cifras están en Resultados: del 75,1 % de claude-sonnet-5, unos 41 puntos son el descuento de la caché de prefijos del propio proveedor, que el sistema informa aparte.
Abstract (original, en inglés)
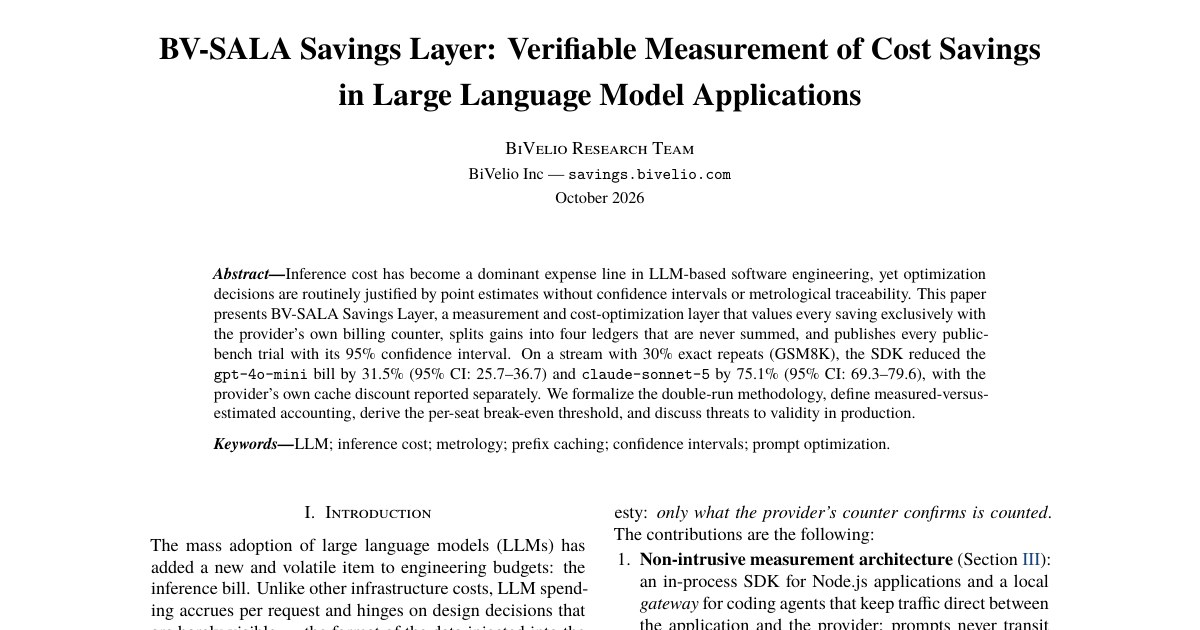
Inference cost has become a dominant expense line in LLM-based software engineering, yet optimization decisions are routinely justified by point estimates without confidence intervals or metrological traceability. This paper presents BV-SALA Savings Layer, a measurement and cost-optimization layer that values every saving exclusively with the provider’s own billing counter, splits gains into four ledgers that are never summed, and publishes every public-bench trial with its 95% confidence interval. On a stream with 30% exact repeats (GSM8K), the SDK reduced the gpt-4o-mini bill by 31.5% (95% CI: 25.7–36.7) and claude-sonnet-5 by 75.1% (95% CI: 69.3–79.6), with the provider’s own cache discount reported separately. We formalize the double-run methodology, define measured-versus-estimated accounting, derive the per-seat break-even threshold, and discuss threats to validity in production.
Palabras clave: LLM; coste de inferencia; metrología; caché de prefijos; intervalos de confianza; optimización de prompts.
Resultados
Las tres pruebas del banco público con cifra publicada. Cada pareja A/B se factura con el mismo instrumento: el contador de cada proveedor. Son las cifras de la tabla 2 y de la figura 2 del paper, en tabla para que se puedan leer sin la imagen.
| Sistema y modelo | Reducción de la factura | IC 95 % | Escenario |
|---|---|---|---|
SDK · gpt-4o-mini (OpenAI) | 31,5 % | 25,7 – 36,7 % | Flujo GSM8K con un 30 % de repeticiones exactas; SDK 0.4.31 |
SDK · claude-sonnet-5 (Anthropic) | 75,1 %, de los que unos 41 puntos son el descuento de la caché de prefijos del proveedor | 69,3 – 79,6 % | El mismo flujo |
| Gateway · palanca PRO en Anthropic (TTL de la caché) | 2,5 % neto | 1,5 – 3,6 % | 51 sesiones de Claude Code de una sola organización (la del propio equipo), a precios de lista |
Cómo leer el 75,1 %
No es un 75 % de ahorro atribuible a la capa. Unos 41 puntos porcentuales de la factura original corresponden al descuento que la caché de prefijos del propio proveedor ya aplicaba; el sistema lo informa aparte, en el cuarto ledger (provider_cached_tokens), no como ahorro de la capa. El resto viene del ledger de llamadas evitadas: las peticiones repetidas se sirven sin una llamada nueva al proveedor.
El resultado no es una previsión: el ahorro depende de cuánta repetición tenga el tráfico de cada organización. El 2,5 % del gateway es ya neto de los fallos de caché que la propia palanca provoca en los turnos encadenados; es un ahorro pequeño que sirve sobre todo para señalar dónde se concentra el gasto. En Gemini se ha verificado que la capa no rompe nada, pero no se publica ninguna cifra de ahorro: sin intervalo publicado no hay cifra.
Método: doble ejecución contra el proveedor real
Cada cifra sale de medir el mismo escenario dos veces, con el mismo modelo y el mismo contenido: sin la capa (condición base) y con ella. El importe de cada condición es el que le atribuye el contador oficial de facturación del proveedor, no un tokenizador propio ni una tabla de precios, que meterían un sesgo sistemático (tokenizadores distintos del que factura, precios desactualizados, descuentos no aplicados). La métrica principal es la reducción relativa de la factura, y su intervalo de confianza del 95 % sale de un remuestreo no paramétrico (bootstrap) de los costes por petición medidos en las dos condiciones.
La regla editorial del sistema es explícita: un porcentaje sin su intervalo, sin su modelo y sin su tráfico no significa nada, así que los tres se publican juntos en cada prueba del banco.
Los cuatro ledgers, que nunca se suman
El informe de ahorro de cada petición (SavingsReport) reparte el ahorro en cuatro ledgers que se informan por separado. Sumarlos se evita a propósito: así el ahorro no se infla por doble cómputo (un token servido por la caché del proveedor no puede presentarse a la vez como ahorro de la capa) y cada ledger responde a una palanca distinta, con su propia dependencia del tráfico.
| Ledger | Qué contiene y cómo se valora |
|---|---|
avoided_calls | Llamadas al LLM, de recuperación o de herramientas que no se llegaron a ejecutar; se valoran con la lectura del contador de la petición idéntica ya ejecutada. |
eliminated_tokens | Información que se quitó del prompt porque no hacía falta; se valora con el contador del proveedor. |
compressed_tokens | Información que se conserva pero se codifica con menos tokens (por ejemplo, reescribiendo datos estructurados). |
provider_cached_tokens | Tokens que siguen en el prompt pero que el proveedor cobra más barato por su propia caché de prefijos. Es el descuento del proveedor, no de la capa, y se informa aparte. |
Además, cada importe se clasifica como medido (lo respalda una lectura del contador del proveedor) o estimado (se valora con tarifas o con el contador de una petición equivalente). Un flujo sin lectura final del contador se registra como no medido y no alimenta ninguna cifra de ahorro medido.
Límites que declara el paper
- Los ledgers no se suman, por diseño: ninguna cifra única resume el efecto total de la capa; hay que leer el desglose.
- El paquete publicado no incluye compresor: el ledger de compresión solo se activa con datos estructurados.
- La cobertura de agentes del gateway es parcial, y la skill de suscripción aún no tiene una medición A/B publicada, así que no se le asocia ninguna cifra.
- Las cifras proceden de contextos concretos (un flujo académico, GSM8K, con la repetición fijada en el 30 %, y 51 sesiones de una sola organización a precios de lista); ninguna debe leerse como previsión individual. La extrapolación defendible es medir la repetición del tráfico propio en modo sombra.
- El origen comercial del trabajo —un equipo que evalúa su propio producto— obliga a tratar las cifras como declaradas y reproducibles mediante el banco público, no como verificadas por un tercero.
En BiVelio Factory
Este paper es el producto 01 del muelle de salida de BiVelio Factory, donde aparecen las aplicaciones, los papers y las empresas que salen de la fábrica. El algoritmo cuyo ahorro mide se explica en BV-SALA · BiVelio Savings Layer.
Descargar y citar
Descargar el paper en PDF (7 páginas, 612 KB, en inglés). El banco público con las pruebas está en savings.bivelio.com.
Cómo citarlo:
BiVelio Research Team (2026). BV-SALA Savings Layer: Verifiable Measurement of Cost Savings in Large Language Model Applications. BiVelio Inc, October 2026. https://research.bivelio.com/papers/bv-sala-savings-layer/
Para leer el algoritmo con más contexto: BiVelio Savings Layer y el artículo BV-SALA: la capa de coste de LLM, por dentro.
- #paper
- #bv-sala
- #llm
- #coste-de-inferencia
- #metrología