
BV-SALA · En producción
BiVelio Savings Layer
Gasta menos en cada llamada a la IA.
Qué es
BV-SALA se coloca entre tu aplicación y la API de IA. Antes de que tu prompt salga, aplica una serie de optimizaciones y modificaciones —compresión, reescritura y reducción de contexto redundante— para que la misma tarea consuma menos tokens y, por tanto, cueste menos.
Cómo funciona
- 1
Recibe tu prompt y el contexto que ibas a enviar.
- 2
Aplica optimizaciones: elimina redundancia, comprime y reescribe manteniendo la intención.
- 3
Envía la versión mínima suficiente a la API que ya usas.
- 4
Te devuelve la respuesta y las métricas de lo que se ahorró.
El paper, en detalle
§1 El problema, formalizado
El proveedor cobra una función esencialmente lineal en tokens, contados con su propio tokenizador. BV-SALA elige π* = argmin E[C(π(x))] sujeto al contrato de calidad Q ≥ τ. La dificultad intrínseca: Q no es observable antes de ejecutar, así que cada transformación del catálogo lleva su propia guarda — se aplica solo donde la evidencia acumulada indica que preserva la intención, y en la duda la petición viaja intacta.
§2 Tres libros contables que no se suman
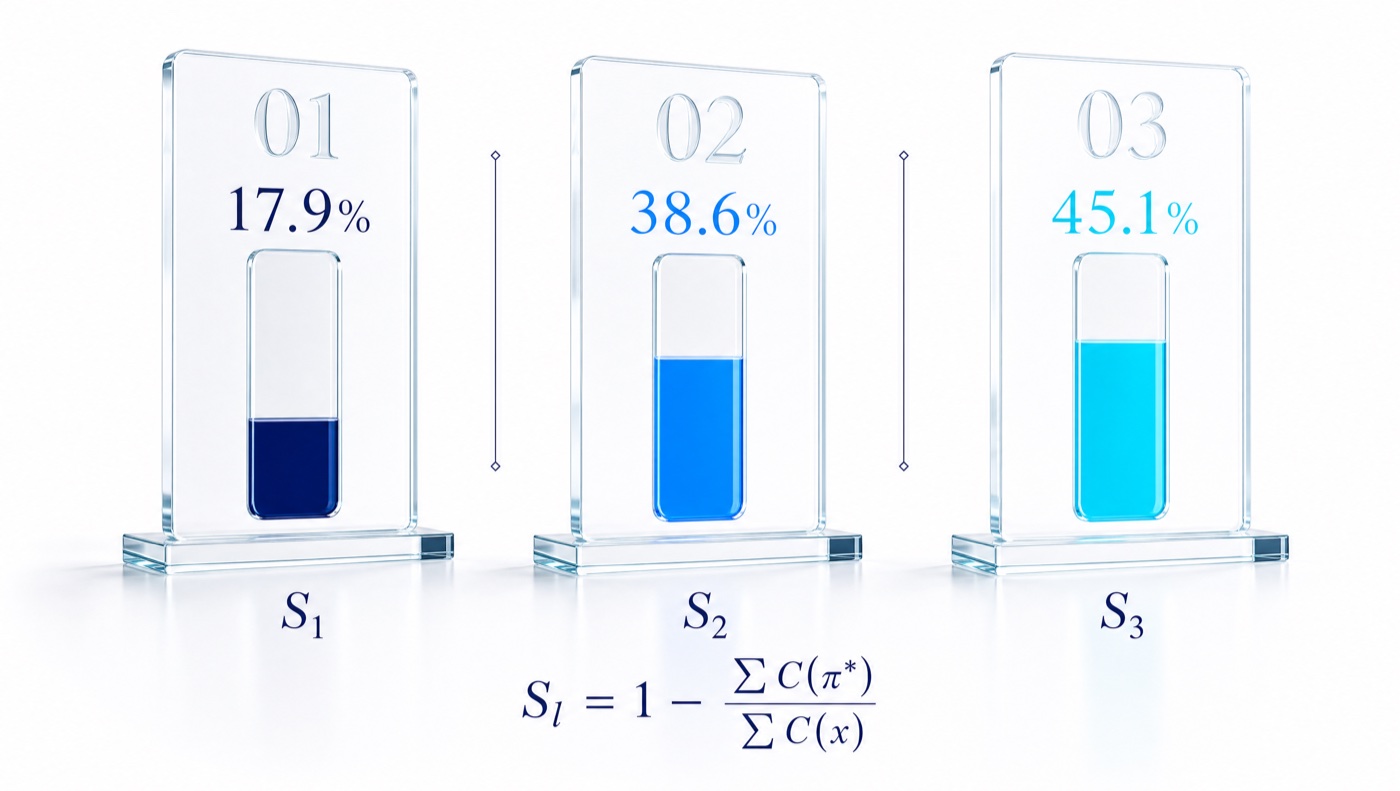
Cada petición optimizada se atribuye a exactamente un libro según el mecanismo dominante: evitar la llamada por completo, quitar lo que no hacía falta enviar o comprimir lo que queda. Cada cifra habla sobre su propio denominador — agregarlas sería contar el mismo euro dos veces — y un libro que no despeja el cero contra los dos brazos de control se publica igual, con su etiqueta, pero no se anuncia.
§3 Medición: el suelo del intervalo
Mismo modelo en dos brazos de control — frente a una integración sin optimizar y frente a la misma integración ya optimizada a mano — y coste cotizado con el contador del propio proveedor, sin línea base modelada. Los escenarios se agregan con un bootstrap estratificado, con peso uno por escenario, y publicamos la cota inferior unilateral del intervalo de confianza al 95 %, nunca la estimación puntual. De ahí que el titular se anuncie como ≥ 20,0 % menos factura en gpt-4o-mini: por debajo de lo que despeja el más exigente de los dos controles.
§4 Contabilidad neta y caché honesta
Analizar cada petición también consume: toda la contabilidad es neta y el ahorro publicado descuenta el coste de la propia capa. Y la caché solo cuenta si la respuesta reutilizada sigue siendo válida: las claves incorporan modelo, versión, herramientas visibles y contexto efectivo — ante cualquier diferencia, se llama.
Qué aporta
- Menos tokens enviados por la misma tarea.
- Funciona con las APIs que ya usas, sin cambiar de proveedor.
- Métricas de ahorro visibles en cada llamada.
Estado
Perfectamente productivizado como producto independiente: savings.bivelio.com — SDK con licencia en npm y ahorro medido contra el contador del propio proveedor, con su intervalo de confianza al lado.
Las cifras que publicamos están medidas, no estimadas — nunca proyecciones. Toda nuestra investigación se ejecuta aprovechando la inferencia y el hardware de NVIDIA.